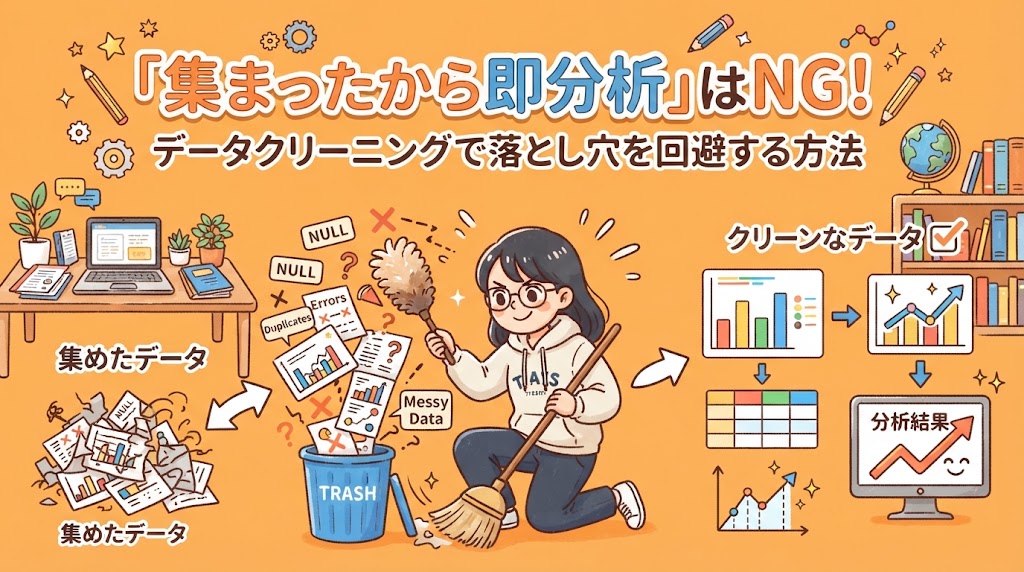
これまでのシリーズでは、卒論制作の全工程を8ステップで俯瞰し、データ分析についても手法やツールの全体像を解説してきました。ここからは、その中でも特につまずきやすい工程を一つずつ深掘りしていきます。最初は、「データ準備」です。
「アンケートの回答が集まったから、さっそく分析にかけよう」と、集めた回答をそのまま分析ソフトに流し込んでしまう人は少なくありません。しかし、集まったばかりの生データ(ローデータ)は、そのままでは分析に使えないことがほとんどです。回答漏れ、矛盾した回答、逆転項目、複数の質問をまとめて一つの得点にする作業など、分析の「前工程」を丁寧に行うかどうかで、その後の分析結果の信頼性が大きく変わります。
この記事では、データ準備で押さえておくべき基礎知識を整理し、そのうえでAIをどう活用できるかを解説します。
1. なぜデータ準備が必要なのか
分析ソフトは、入力されたデータをそのまま計算します。つまり、データの中に矛盾や誤りが含まれていても、ソフトは何も指摘せず、そのまま(誤った)結果を出力してしまいます。俗に「Garbage In, Garbage Out(ゴミを入れれば、ゴミが出てくる)」と言われる通り、どれだけ立派な分析手法を使っても、元のデータが整っていなければ意味のある結果は得られません。
データ準備とは、集まった生データを、分析に耐えられる正確な形に整えるための一連の作業です。地味に見える工程ですが、実はこの段階こそが、卒論の結果の信頼性を左右する最も重要な工程の一つだと言っても過言ではありません。
2. 生データは必ず別で保存する
データ準備を始める前に、まず集まった生データ(回答をそのまま出力したファイル)は、絶対に上書きせず、別名で必ず保存しておくことを徹底してください。
データ準備の過程では、不要な回答の削除、値の修正、新しい変数の作成など、データを直接いじる作業が続きます。作業を進めるうちに「あの処理をする前の状態に戻したい」という場面が必ず出てきます。そのときに生データが残っていないと、最初からやり直すことになりかねません。
ファイル名には「raw(生データ)」「cleaned(整形済み)」のように、どの段階のデータかが一目で分かる名前をつけておくと安心です。
3. 欠損値(回答漏れ)への対応
アンケートの中には、一部の質問に無回答のまま提出されたデータ(欠損値)が必ずと言っていいほど含まれます。欠損値への対応には、主に以下のパターンがあります。
- その回答者ごと除外する(リストワイズ除去):無回答の質問が一つでもあれば、その回答者のデータを分析から除外する方法。シンプルですが、除外する回答者が多いとサンプルサイズが大きく減ってしまいます。
- その質問項目だけ除外する(ペアワイズ除去):分析ごとに、必要な項目に回答している人だけを対象にする方法。
- 平均値や中央値で補完する:欠損している値を、その項目の平均値などで穴埋めする方法。ただし、この方法はデータの分布を歪める可能性があるため、卒論レベルでは慎重な判断が必要です。
多くの学生の卒論では、まずリストワイズ除去(無回答が一つでもあれば除外)というシンプルな方法が使われることが多いですが、除外によってサンプルサイズがどれだけ減ったかは必ず記録し、卒論の本文(研究方法の章)にも明記しましょう。
4. 不正回答・外れ値のチェック
集まったデータの中には、真剣に回答されていない、あるいは矛盾したデータが混ざっていることがあります。以下のようなパターンに注意しましょう。
- すべての質問に同じ選択肢で回答している(例:20項目すべてに「3」とだけ回答している)
- 回答時間が極端に短い(Web調査でアンケートの回答時間を記録している場合、内容を読まずに回答したと考えられる極端に短い回答時間のデータ)
- 矛盾した回答をしている(例:「SNSを全く利用しない」と回答しているのに、「SNSを1日3時間以上利用する」とも回答している)
- 数値として現実的にありえない値(例:年齢の回答欄に「150」と入力されている)
これらの回答をどこまで除外するかについては、あらかじめ「除外の基準」を自分の中で決めておき、その基準を卒論の本文にも明記することが重要です。「なんとなく怪しいから除外した」という主観的な判断ではなく、「回答時間が全体の平均の半分未満のデータは除外する」のように、客観的に説明できる基準を設けましょう。
5. 逆転項目の処理
アンケートの中には、あえて質問の意味を逆にした項目(逆転項目)を混ぜることがあります。例えば「授業に集中できる」という項目群の中に、あえて「授業中、他のことに気を取られやすい」という逆向きの項目を混ぜることで、回答者が内容をよく考えずに同じ選択肢ばかり選んでいないかを確認する役割があります。
このような逆転項目は、そのまま合計・平均を計算すると数値の意味が逆転してしまうため、分析の前に得点を反転させる処理が必要です。5段階評価であれば、「6から元の回答を引く」という計算(1→5、2→4、3→3、4→2、5→1)で反転させるのが一般的です。
自分の調査票にこうした逆転項目を含めていた場合、分析前に必ずこの処理を行っているかを確認しましょう。
6. 尺度の合成得点を作る
複数の質問項目で一つの概念(例:「学習集中力」を4つの質問で測定している場合など)を測定している場合、それらの項目の平均値、または合計値を計算し、一つの「合成得点」としてまとめる作業が必要です。
この合成得点を分析に使うことで、一つひとつの質問項目のブレを均し、より安定した指標として扱うことができます。ここでも、逆転項目があれば、必ず反転処理を済ませたうえで合成得点を計算する必要があります。
7. カテゴリ変数のコード化
性別、学年、学部といった、数値ではなく分類(カテゴリ)で回答されている項目は、分析ソフトで扱いやすいように数値へ変換(コード化)しておくのが一般的です。例えば「男性=1、女性=2」のように数値を割り振ります。
回帰分析などで、カテゴリ変数をそのまま独立変数として使いたい場合は、「ダミー変数」と呼ばれる0と1だけで表現する形に変換する必要があります。この変換は分析手法によって必要かどうかが変わるため、自分が使う予定の分析手法に応じて、事前に確認しておきましょう。
8. コードブック(変数の説明書)を作る
データ準備の最後に、「どの列がどの質問に対応していて、どの数値が何を意味するか」を一覧にした「コードブック」を作成しておくことを強くおすすめします。
例えば以下のような表です。
| 変数名 | 内容 | 値の意味 |
|---|---|---|
| gender | 性別 | 1=男性、2=女性、3=その他 |
| grade | 学年 | 1〜4(1年生〜4年生) |
| watch_time | 動画視聴時間(分/日) | 数値そのまま |
| concentration | 学習集中力(4項目の合成得点) | 1〜5の範囲(数値が高いほど集中力が高い) |
コードブックを作っておくと、分析の途中で「この変数、何を意味していたか忘れた」という事態を防げるだけでなく、卒論の研究方法の章を書く際にも、そのまま活用できる資料になります。
9. ここでAIをどう活用するか
データ準備の基本工程を押さえたところで、AIの出番です。ここでの活用は、主に「地道な作業の効率化」と「処理の見落としチェック」の2つに整理できます。
活用①:データ整形のコードを作成してもらう
R・Pythonを使う場合、欠損値の除外、逆転項目の反転、合成得点の作成といった、繰り返しの多い作業のコードをAIに作成してもらうと、大幅に時間を短縮できます。
以下の条件で、R(またはPython)を用いてデータ整形を行うコードを
作成してください。

# データ:
CSV形式、列名は以下の通り
・q1〜q4:学習集中力に関する4項目(5段階のリッカート尺度)
・q3は逆転項目
・watch_time:動画視聴時間(分)
・gender:性別(1=男性、2=女性、3=その他)

# 行いたい処理:
1. q1〜q4のいずれかが欠損しているデータを除外する
2. q3を反転させる(6-元の値)
3. q1〜q4(反転後)の平均値を「concentration」という新しい列として作成する
4. genderをダミー変数化する
活用②:除外基準・処理方針を相談する
「回答時間が極端に短いデータをどう扱うか」など、除外基準に迷ったときに、一般的な考え方や判断基準の候補を相談することができます。
アンケート調査で、回答時間が極端に短いデータの扱いに迷っています。
一般的にどのような基準で「不正回答」と判断されることが多いか、
具体的な基準の例をいくつか教えてください。
また、その基準を卒論の研究方法の章に書く際、
どのような書き方をすれば説明として十分か教えてください。
活用③:コードブックの下書きを作ってもらう
自分が使った質問項目のリストをAIに渡し、コードブックの形式に整えてもらうことができます。
以下は、私が使用したアンケートの質問項目リストです。
これをもとに、変数名・内容・値の意味を一覧にした
コードブックの下書きを作成してください。
変数名は分析で使いやすいよう、英語の短い名前を提案してください。

# 質問項目リスト:
[質問項目を貼り付け]
使う上での注意点
AIに生成してもらったコードは、必ず実際にデータに適用した結果(処理前後の件数、平均値の変化など)を自分の目で確認しましょう。特に欠損値除外の処理は、意図した通りの件数が除外されているかを毎回チェックする習慣をつけることが重要です。コードが「動く」ことと、処理の内容が「自分の意図通りである」ことは別問題です。
10. まとめ
データ準備は、地味に見えて、分析結果の信頼性を左右する重要な工程です。生データの保存、欠損値・不正回答への対応、逆転項目の反転、合成得点の作成、カテゴリ変数のコード化、そしてコードブックの作成という一連の流れを、客観的な基準を持って進めることが、説得力のある分析・考察につながります。
AIは、繰り返しの多いデータ整形のコード作成や、判断基準の相談、コードブックの整形といった場面で強力な助けになりますが、処理結果が意図通りになっているかの確認は、必ず自分の目で行いましょう。
次回は、データ準備が終わったあと、実際に分析にかける前の「記述統計・データの傾向把握」について、より詳しく解説する予定です。
関連記事
コメント